pandasのmergeによる表結合を深掘り解説(チートシート形式)
Aru
Aru's テクログ(Aruaru0)
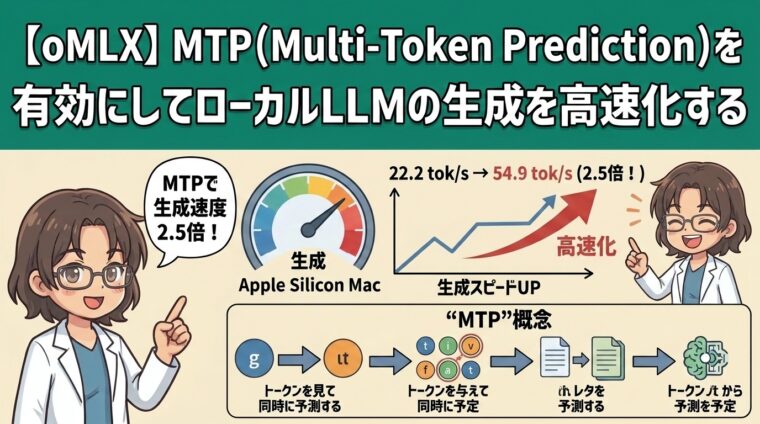
Mac向けのLLM推論サーバーのoMLX の「Lightning MTP」を有効にして、Apple Silicon の Mac でローカルLLMの生成を速くする方法をまとめました。設定画面の場所、MTP 対応モデルの条件、M4 Max で MTP を ON/OFF した実測(生成 22.2 → 54.9 tok/s)、Qwen ANE Prefill によるプロンプト処理の短縮まで、実際の画面とログを交えて紹介します。
ローカルLLMの待ち時間は、大きく2つに分かれます。
prefillは入力された文章をまとめて処理するもので、decodeはAIの回答を出力する部分になります。対話でAIの出力が出てくるのは後者のdecode処理です。エージェント用途の場合、プログラムコードや仕様書などの入力が多くなるためprefill が支配的なことが多いです。
oMLX には、モデル内蔵の MTP ヘッドを使って decode を速くする Lightning MTP が用意されています。設定はモデルごとのスイッチで、有効にすると次にモデルを読み込んだときから適用されます。
この記事では、私の環境で Lightning MTP を ON/OFF して計測した結果と、設定手順についてまとめました。
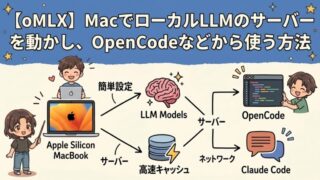
MTP(Multi-Token Prediction)とは、1回の推論で複数トークン先まで予測し、生成を高速化する仕組みです。モデルに内蔵された MTP ヘッドで下書きを作り、本体モデルでまとめて検証します。
MTP はもともと、学習向けの手法ですが、推論ではその MTP ヘッドを「下書き役」として使い、投機的デコーディング(speculative decoding) として利用します。
具体的には、投機的でコーディングでは、小さいモデルで複数トークンを予測し、本体のモデルで検証して問題がなければ一気に確定させる手法です。
処理の流れは以下の通りです
decode はメモリ帯域の制約を受けやすい処理で、1トークンずつ重みを読み直すより、複数トークンをまとめて検証するほうが、同じ時間で多くのトークンを進めることができるからです。
ただし、下書きが当たるほど得をし、外れるほど無駄が増えます。
oMLX の設定画面には、Lightning MTP について次の説明があります。
Drafts several tokens per step with the model’s built-in MTP head. Up to ~1.5x faster decoding for supported models.
モデル内蔵の MTP ヘッドで数トークンを下書きし、対応モデルでは decode が最大で約1.5倍になる、という意味です。この「約1.5倍」は控えめな数字で、実際の倍率はモデルやプロンプトによって変わります。
MTP は、どのモデルでも有効にできるわけではありません。oMLX はモデルごとに対応可否を判定しています。
config.json に MTP 層の記述があっても、重みファイルに mtp.* テンソルが含まれていないと使えませんconfig.json の model_type が対応ファミリー(qwen3_5 系、qwen3_6 系、deepseek_v4 系など)であること。モデル名が Qwen3.8 でも、内部形式が qwen3_5 として判定されるチェックポイントは対象です(私の Qwen3.8-27B-oQ4e-mtp がその例です)私が確認したのは以下のモデルになります。
config.json には MTP 層の記述があるものの、重みファイルに mtp.* が含まれていませんでした。oMLX のモデル情報には「MTP 重みを保持するコンバーターで再変換してください」という趣旨の理由が返ってきましたこのように、MTP を使いたいときは、MTP 重みが残ったチェックポイントを選ぶ必要があります。
設定画面の Adaptive max depth は、1回の検証サイクルで先読みするトークン数の上限です。既定は3トークンです。
確認すると、この値は固定ではなく、受理率とレイテンシの実測値を見ながら 1〜上限の範囲で毎サイクル選ばれています。深くすれば1回で確定できるトークンが増えますが、下書きが外れたときのコストも増えます。効率が通常の decode を下回る状態が続くと、MTP を一時停止(park)して通常の decode に戻す制御もあります。
注意点は、MTP をオンにしても常に MTP が動き続けるわけではありません。向かない条件では自動的に通常の生成へ戻ります。
私の環境のログでは、3トークン設定でも深さ4のサイクルがありました。Qwen の27Bモデルでは、実装側で最低4トークンまで使うようになっているためです。設定値は「上限の目安」と考えておくほうがよさそうです。
また、MTP が使えるのは単独リクエストだけではありません。キャッシュ位置が揃った同時リクエストのバッチでも使われます。位置が揃わない連続バッチでは、自動的に通常の decode へフォールバックします。
MTP は、同じモデルで他の投機的デコーディングと同時に使えません。加えて、メモリ節約系の設定ともぶつかることがあります。
「設定したのに速くならない」「オンにできない」ときは、まず他の投機設定が有効になっていないか確認してください。
ここからは、実際の画面に沿って設定手順を説明します。macOS アプリ版の oMLX を使っています。
メニューバーの oMLX アイコンから Settings…(⌘,)を選びます。
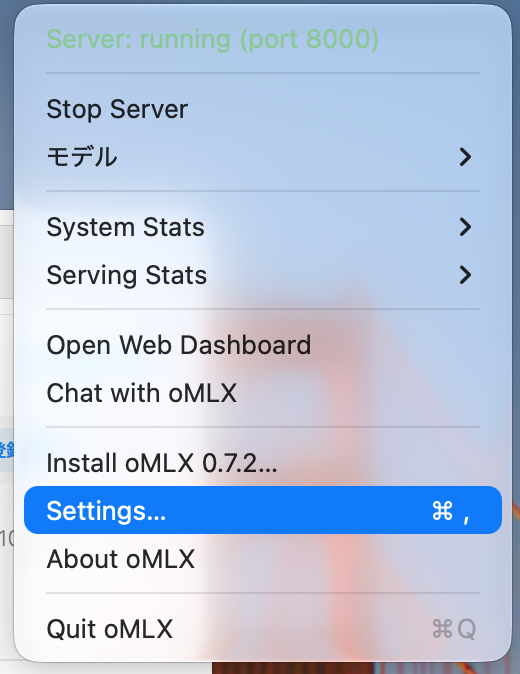
メニューバーの「Settings…」から設定画面を開きます
左側のメニューで モデル を選び、一覧から MTP を使いたいモデルをクリックします。私の環境では Jundot/Qwen3.8-27B-oQ4e-mtp を選びました。
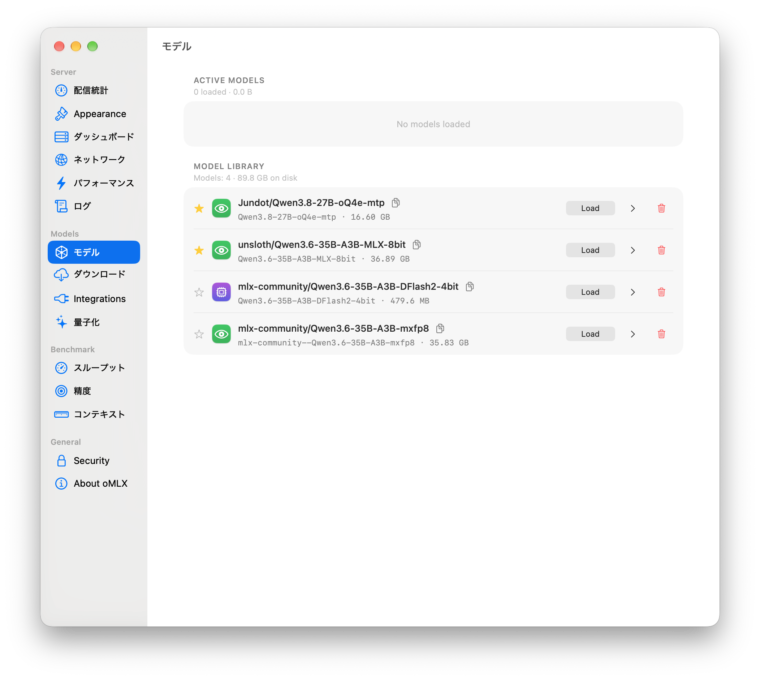
モデル一覧。「Load」の右横の「>」をクリックすると詳細を開けます
モデル詳細の Profiles / Basic / Advanced から Advanced を選びます。
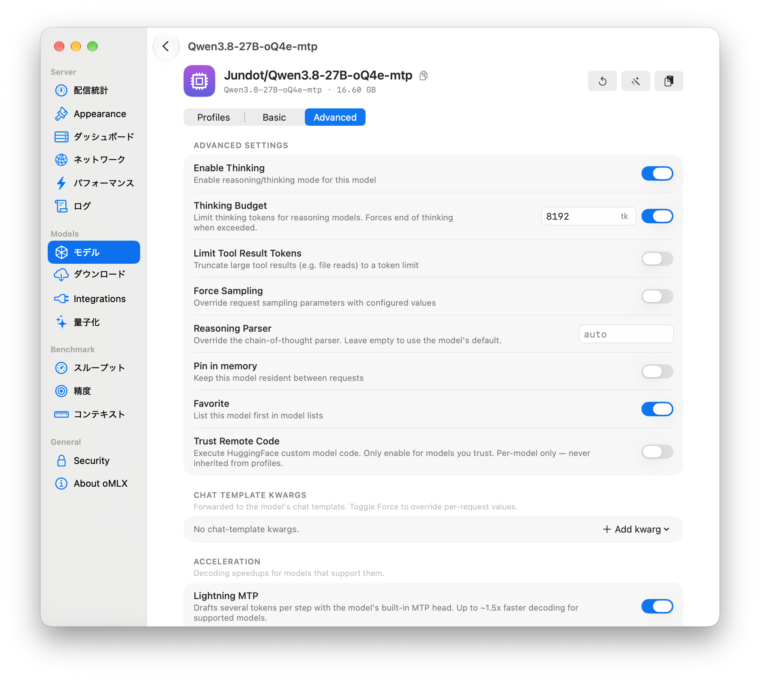
ACCELERATION セクションの Lightning MTP をオンにします。Adaptive max depth は、まず既定の 3 tokens (Default) で試すのが無難です。
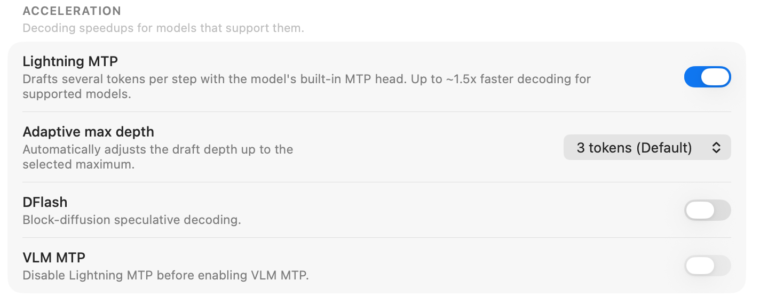
深度を上げると1サイクルで進めるトークン数が増えますが、下書きが外れたときのコストも増えます。とりあえず3のままにして調整してするのが良いと思います。
同じ場所にある DFlash と VLM MTP は別方式です。Lightning MTP と同時には使えません。
omlx serve の CLI には MTP 用のフラグがありません(0.7.0 で確認)。モデル単位の設定なので、GUI から変更します。
設定値は ~/.omlx/model_settings.json の mtp_enabled と mtp_adaptive_max_depth に保存されます。通常は GUI から変更するほうが安全です。
MTP は生成を速くする設定ですが、待ち時間全体を短くしたいなら、プロンプト処理側の設定も確認しておくとよいです。EXPERIMENTAL セクションには、Qwen 系のプロンプト処理を ANE(Apple Neural Engine)と GPU に分割する Qwen ANE Prefill があります。
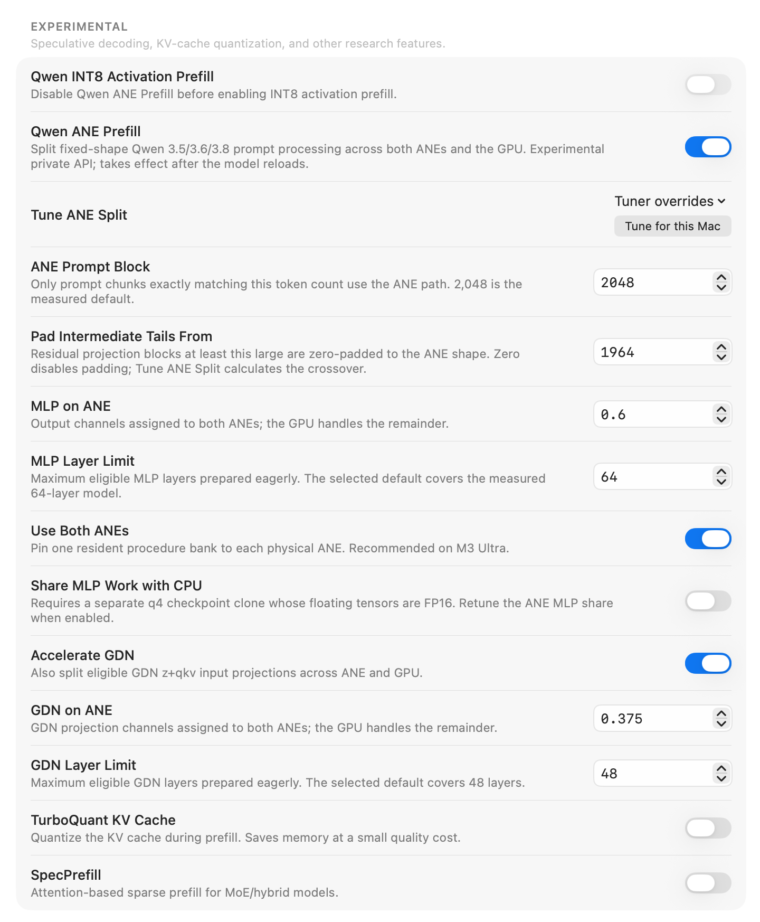
Tune ANE Split の Tune for this Mac を押すと計測が行われます。これを反映させると、その Mac に合わせた値が設定されます。私の環境では、次の値が入りました。
これらは実験的な機能で、MTP とは独立しています。MTP の効果だけを比べたいときは、このあたりの設定を ON/OFF で揃えてください。なお、Qwen ANE Prefill はプロンプト処理を速くするための設定で、生成速度には効きません。
管理画面のベンチマークでも測れますが、ここでは OpenAI 互換 API に同じプロンプトをストリーミングで送り、最初のチャンクが届くまでの時間(TTFT)と usage のトークン数から計算しました。
プロンプトは約2,180トークン、出力は256トークン、temperature は0です。プレフィックスキャッシュの影響を避けるため、各リクエストの先頭に固有の文字列を入れています。MTP の ON/OFF は同日に続けて計測し、設定を切り替えてモデルを再ロードしたうえで、それぞれ3回測った中央値を採用しました。
| 項目 | 値 |
|---|---|
| マシン | MacBook Pro(M4 Max、128GB) |
| oMLX | 0.7.2(macOS アプリ版) |
| モデル | Qwen3.8-27B-oQ4e-mtp(16.60GB) |
| プロンプト | 約2,180トークン |
| 出力 | 256トークン |
| temperature | 0 |
| その他 | Qwen ANE Prefill 有効(ANE Prompt Block 2048) |
プロンプト処理の速度は prompt_tokens ÷ TTFT、生成速度は (completion_tokens - 1) ÷ (合計時間 - TTFT) として計算しています。TTFT にはキュー待ちや通信の時間も含まれるため、プロンプト処理の値は概算です。使用したのは /v1/completions で、stream_options.include_usage を有効にして usage を取得しました。
| 設定 | プロンプト処理 | 生成 | 最初のトークン | 合計時間 |
|---|---|---|---|---|
| MTP ON | 234.8 tok/s | 54.9 tok/s | 9.28秒 | 13.9秒 |
| MTP OFF | 239.4 tok/s | 22.2 tok/s | 9.11秒 | 20.6秒 |
結果を整理すると、次の3点です。
生成が2.5倍になっても、体感が2.5倍にならないのは、最初のトークンまでの9秒が固定費として残るからです。全体の時間は、おおよそ次の式で表せます。
全体の時間 ≒ 最初のトークンまでの時間 + 出力トークン数 ÷ 生成 tok/s
MTP OFF では 9.11 + 256 ÷ 22.24 ≒ 20.6秒、MTP ON では 9.28 + 256 ÷ 54.91 ≒ 13.9秒 となり、実測とほぼ一致します。この式でわかるのは、出力が短いほど MTP の効果が小さく、出力が長いほど効果が大きい、ということです。
サーバーログに表示される「256 tokens in 13.59s (54.0 tok/s)」のような数値は decode の速度で、プロンプト処理は含みません。ログの数値と合計時間から計算した数値が一致しないときは、どちらの速度を見ているかを確認してください。
MTP がどれくらい当たっているかは、サーバーログで確認できます。256トークンを生成したときのログがこちらです(読みやすいように改行しています)。
MTP[1] finish=length tokens=256 cycles=58 tok/cycle=4.41 accept=196/197 (99.5%)
depth[d1=54/55,d2=53/53,d3=50/50,d4=39/39] d0=3
timing[backbone=4254.3ms mtp=224.7ms sample=4.7ms cache=152.7ms]
読み方は次のとおりです。
このログでは、MTP ヘッドの追加コストは本体のフォワードパス時間に対して5%程度です。本体のフォワードパス回数を減らすことで、全体として速くなっていることがわかります。
ただし、この99.5%という受理率は、temperature 0 で説明的な文章を続けた条件のものです。創作や多様な出力を求める設定では受理率が下がり、効果も小さくなる可能性があります。
同じ設定でも、連続して計測すると数値は変動しました。今回の一連の計測では、MTP ON で 32〜66 tok/s、MTP OFF で 11〜23 tok/s の範囲でした。出力長や熱、バックグラウンドの負荷で変わります。最初の1回だけを見ると、そのときの状態に引っ張られてしまいます。
64トークンと512トークンでも試しました。どちらも MTP のほうが速いという傾向は同じでしたが、短い出力では合計時間の短縮幅が小さくなります。
エージェント用途のように「プロンプトが長く、出力が短い」使い方では、MTP だけでは待ち時間は大きく減りません。ただし、oMLX の KV キャッシュが効いてプロンプト処理が短縮されると、相対的に decode の割合が増えるため、MTP の効果を感じやすくなります。長文の生成や要約のように、出力が長いタスクほど効果は大きいです。
MTP は生成だけを速くしますが、待ち時間全体を縮めるにはプロンプト処理の短縮も効きます。私の環境では Qwen ANE Prefill がオンになっているので、MTP を ON のまま、Qwen ANE Prefill だけを OFF にして同じ条件で測ってみました。この比較は、前述の MTP の表とは別のセッションで測り直したものです。
| 設定 | プロンプト処理 | 最初のトークン | 合計時間 | 生成 |
|---|---|---|---|---|
| Qwen ANE Prefill ON | 223.1 tok/s | 9.77秒 | 14.6秒 | 52.6 tok/s |
| Qwen ANE Prefill OFF | 178.3 tok/s | 12.22秒 | 16.9秒 | 54.9 tok/s |
Qwen ANE Prefill をオンにすると、プロンプト処理は 178.3 → 223.1 tok/s(約1.25倍)になり、最初のトークンまでの時間は 12.22秒 → 9.77秒 と約2.4秒短くなりました。生成速度は 52.6 と 54.9 tok/s で、この計測では差は誤差の範囲です。Qwen ANE Prefill は prefill にだけ効き、decode にはほとんど影響していません。
最初に測ったときは、ON で 247.0 tok/s・8.82秒でした。熱の状態で数値は動くため、効果は「約1.25〜1.4倍、TTFT で2.5〜3.5秒の短縮」と幅を持って見てください。
Qwen ANE Prefill は、ANE Prompt Block(2048トークン)に一致するチャンクだけを ANE に回します。プロンプトが2048トークン未満だと効果が出にくく、長いプロンプトほど差が見えやすいです。私の計測は約2,180トークンのプロンプトで、ANE Prompt Block を超える長さの条件でした。
Qwen ANE Prefill は実験的な機能で、Qwen3.5/3.6/3.8 系が対象です。MTP とは独立しているので、私の環境では両方をオンにしたまま使っています。相性が悪いと感じたら、個別に切り替えて測ってください。
oMLX には、MTP 以外にも生成やプロンプト処理を速くする設定があります。主なものを整理すると、次のようになります。
| 方式 | 仕組み | 向いている処理 | 制約 |
|---|---|---|---|
| Lightning MTP | モデル内蔵の MTP ヘッドで下書き | 生成(decode) | MTP ヘッド入りのモデルが必要 |
| DFlash | 別のドラフトモデル(block diffusion)で下書き | 生成(decode) | ドラフトモデルの追加ロードが必要 |
| VLM MTP | VLM 用のアシスタントモデルで下書き | VLM の生成 | Lightning MTP と排他 |
| SpecPrefill | Attention を間引いてプロンプトを処理 | プロンプト処理(prefill) | MoE / ハイブリッド向けの実験機能 |
| Qwen ANE Prefill | プロンプト処理を ANE と GPU に分割 | プロンプト処理(prefill) | Qwen 系・2048トークン単位(実験機能) |
| KV キャッシュ | 共通のプレフィックスを再利用 | 長いコンテキストの TTFT | プレフィックスが一致する必要がある |
Qwen ANE Prefill は、私の環境でプロンプト処理を約1.25倍にし、TTFT を約2.4秒短縮しました。
MTP は、ローカルLLMの生成速度を上げるための有効な手段です。私の環境では、約2,180トークンのプロンプトに対して256トークンを出力する条件で、生成が 22.2 tok/s から 54.9 tok/s へ上がり、合計時間は 20.6秒から13.9秒になりました。設定はモデルごとのスイッチ1つで、MTP ヘッド入りのモデルを選べば難しくありません。
一方で、速くなるのは decode だけです。最初のトークンまでの9秒はそのまま残るため、出力が短いタスクでは体感の短縮は小さくなります。プロンプト処理は Qwen ANE Prefill で短縮でき、私の環境では TTFT が約2.4秒短くなりました。MTP と ANE Prefill は別の工程に効くので、両方を有効にすると生成とプロンプト処理の両方を短縮できます。MTP を入れるべきかは、プロンプト長と出力長のバランスで決まります。長い文章を書かせる用途や、KV キャッシュでプロンプト処理が短くなっている用途ほど、効果を感じやすいです。